ファクトはAIによる自動抽出です。誤りが含まれる可能性があります。正確な情報は原資料をご確認ください。
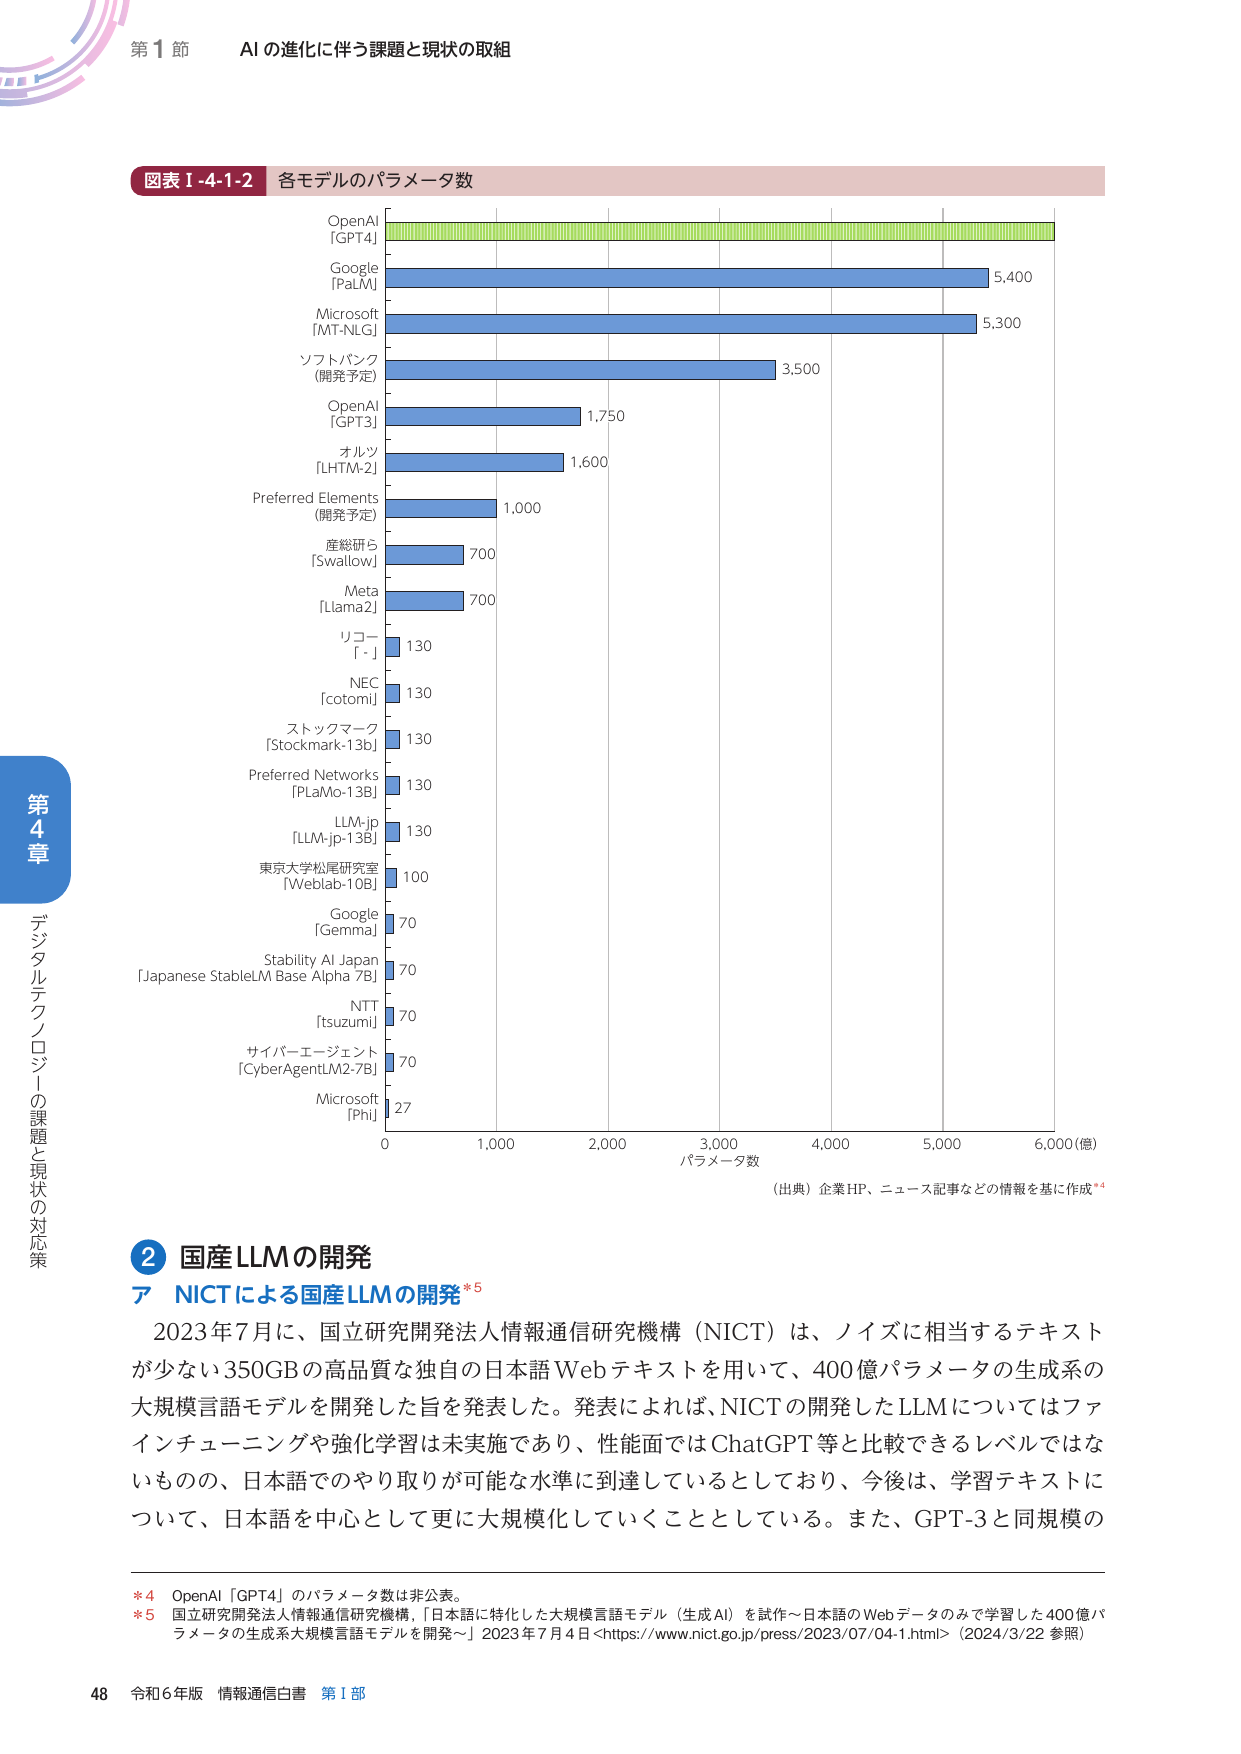
Q. NICTが400億パラメータの大規模言語モデルを開発(2023年)はどれくらいですか?
A.2023年のNICTが400億パラメータの大規模言語モデルを開発は400億。
NICTは2023年7月、高品質な日本語Webテキスト(350GB)を用いて400億パラメータの大規模言語モデルを開発したと発表した。
出典: 総務省『令和6年版 情報通信白書(全体版)』2024年7月公表
出典スライド